引言
人工智能的浪潮正以前所未有的速度重塑世界,而算力則是驅動這一浪潮的核心引擎。在以GPU為代表的高端AI芯片領域,國際出口管制不斷升級,形成了嚴峻的“算力封鎖”。中國AI產業要高速發展,必須攻克國產GPU的算力瓶頸。誰能擔此重任?答案不僅在于硬件本身的突破,更在于人工智能基礎軟件的協同創新。
一、算力封鎖的現實與國產GPU的使命
美國對華高端GPU(如NVIDIA A100/H100等)的出口限制,使國內AI大模型訓練面臨算力緊缺。國產GPU企業如壁仞科技、摩爾線程、天數智芯、寒武紀、海光信息等紛紛發力,試圖填補這一空白。它們的目標不是簡單復刻國際巨頭,而是要在架構、生態、軟件棧上走出一條自主之路。
GPU的成功從來不是單點硬件突破。國際龍頭NVIDIA的強大,一半來自CUDA生態。國產GPU若只靠硬件算力提升,而缺乏匹配的人工智能基礎軟件,就無法讓開發者“用得起來”,也就無法真正推動AI高速發展。
二、基石:人工智能基礎軟件開發
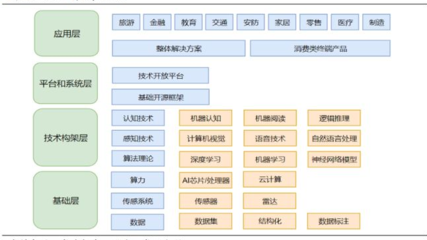
人工智能基礎軟件是連接上層AI框架(PyTorch、TensorFlow、PaddlePaddle等)和底層芯片的橋梁,主要包括:
- 編程模型與編譯器:如針對國產GPU的并行計算語言、LLVM/MLIR后端優化,將AI算子高效映射到硬件。
- 算子庫與通信庫:定制高性能算子(矩陣乘、卷積、注意力等)及集合通信庫(類似NCCL),支持大規模分布式訓練。
- AI框架適配層:讓主流框架無縫支持國產GPU,降低遷移成本。
- 推理引擎與部署工具:如OpenVINO、TensorRT的替代方案,實現端到端優化。
沒有這些基礎軟件,國產GPU就是“有硬無軟”的空殼,無法被AI開發者接納翻譯成實際生產力。
三、誰能突破?硬軟協同的先行者
- 壁仞科技:其BR100系列GPU強調算力對標國際,同時自研BIRENSUPA軟件平臺,試圖構建從編譯器到框架適配的完整棧。
- 摩爾線程:MUSA統一系統架構覆蓋圖形與計算,提供 musify 遷移工具,幫助CUDA應用低成本移植,生態思路清晰。
- 華為昇騰:雖然并非傳統GPU,但其CANN基礎軟件棧和MindSpore框架形成硬軟一體,是國產AI基礎軟件的成功范例,為GPU廠商提供參考。
- 寒武紀:早期以思元芯片+Cambricon Neuware軟件棧著稱,積累了較強的編譯器與庫能力。
- 天數智芯:天垓訓練卡與智鎧推理卡配合自研軟件棧,注重框架兼容。
真正的突破者將是那些敢于在編譯器、算子庫、分布式訓練框架上長期投入,并開放生態、擁抱開源(如與PyTorch、PaddlePaddle社區深度合作)的企業。單純堆砌硬件算力,無法打破封鎖。
四、推動中國AI高速發展的路徑
- 軟硬協同設計:GPU架構需針對AI負載優化,同時軟件提前介入,實現“設計即支持”。
- 開源開放生態:聯合發起國產AI基礎軟件開源項目,吸引全球開發者,避免重復造輪子。
- 標準與接口統一:避免各廠商私有多套軟件棧造成的碎片化。通過聯盟推動統一編程接口和算子標準。
- 人才培養與社區運營:CUDA的護城河本質是開發者習慣。國產GPU必須投入大量資源做培訓、文檔、示例、競賽。
- 政策與產業協同:國家專項支持基礎軟件研發,鼓勵AI企業試用國產算力,形成反饋閉環。
五、
國產GPU突破算力封鎖,不是一場簡單的芯片競賽,而是一場硬件、基礎軟件、開發者生態的系統性戰役。誰能率先構建起好用、易用、開放的AI基礎軟件平臺,誰就能真正將國產GPU的算力轉化為中國AI高速發展的動力。這條路沒有捷徑,但每一步扎實的軟件創新,都在為最終破局鋪路。未來已來,只待硬軟同心的突圍者。