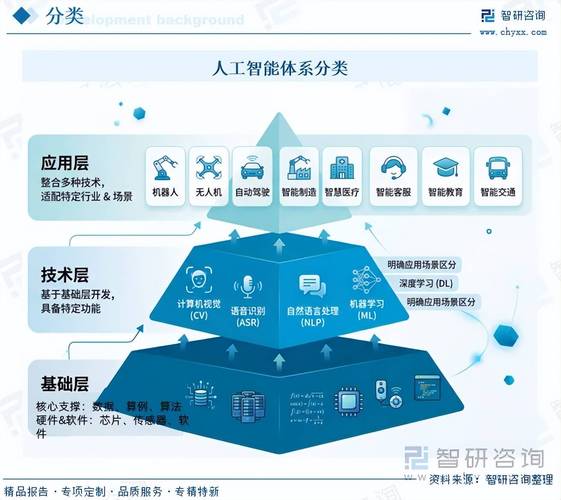
在人工智能的璀璨星河中,大模型、深度學習、生成式AI等技術術語占據(jù)了舞臺的中心。在這光鮮的技術表象之下,有一條看不見卻至關重要的基石在默默支撐著一切:數(shù)據(jù)。事實上,人工智能實踐的每一步都在強調一個不爭的真諦:即使是最頂尖的算法,其所有“智能”的來源也離不開數(shù)據(jù)的清洗、治理和建模。從人工智能基礎軟件的開發(fā)底層邏輯看,這不僅是一個工具棧的問題,更是一場對數(shù)據(jù)價值的系統(tǒng)性重塑。\n\n### 一、數(shù)據(jù)基礎設施是第一生產力的實現(xiàn)路徑\n\n很多人曾困在誤區(qū)中:是否只要引入了AI模型,企業(yè)業(yè)務就會立刻智能?答案是否定的。人工智能的所謂“高科技感”從來不是魔幻變形,而是建立在高德的數(shù)據(jù)成熟度(Data Maturity)之上。如果原始工序還未實現(xiàn)數(shù)據(jù)治理、語料采集的過程不具多樣性,或者人工標注(ground truth)噪音過大,那么多GPU堆模型的邏輯就會阻塞在初始階段。缺乏高質量的行業(yè)視角數(shù)據(jù)庫,公司就像要在農田之上放高樓,無疑適得其反。從這點看,基礎軟件投入成本的最大邊際匯聚便回到了對如何搭建容納清洗規(guī)則下的適配材料結構的問題。這種觀點解釋第一性原理:data決定了智能的上邊界限度,模型運作的唯一任務只是使現(xiàn)實的分布趨于特征,這也成為解決方案團隊開發(fā)工業(yè)情境時判斷的關鍵實踐準備。“臟數(shù)據(jù)從來無法構建穩(wěn)健連接鏈路\
數(shù)據(jù)為基 人工智能基礎軟件開發(fā)的根脈與藍圖
如若轉載,請注明出處:http://www.supermimi.cn/product/28.html
更新時間:2026-10-24 02:36:29